Bài 6: Từ hiểu dữ liệu đến chuẩn bị dữ liệu
Mục tiêu bài học
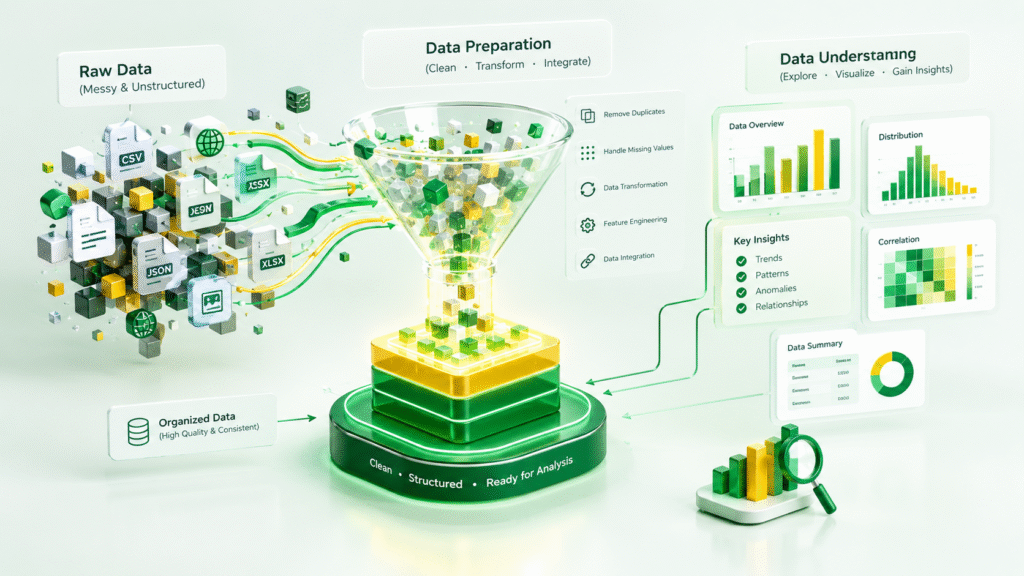
Trong bài học này, bạn sẽ khám phá hai giai đoạn tiêu tốn nhiều thời gian và công sức nhất trong toàn bộ phương pháp luận Khoa học dữ liệu: Hiểu dữ liệu (Data Understanding) và Chuẩn bị dữ liệu (Data Preparation). Bạn sẽ tìm hiểu cách đánh giá tính đại diện của dữ liệu, áp dụng các kỹ thuật làm sạch, chuyển đổi và biến đổi dữ liệu thực tế trước khi bước vào giai đoạn mô hình hóa.
Giải thích ý nghĩa và vai trò của hai giai đoạn Hiểu dữ liệu và Chuẩn bị dữ liệu trong phương pháp luận Khoa học dữ liệu.
Mô tả các quy trình, kỹ thuật chuẩn bị dữ liệu thực tế như chuyển đổi dữ liệu, xử lý giá trị thiếu, Feature Engineering và phân tích văn bản.
Áp dụng thực tiễn các bước trong giai đoạn hiểu và chuẩn bị dữ liệu vào bài toán phân loại thực tế thông qua case study và bài thực hành Lab.
1. Hiểu dữ liệu (Data Understanding)
Giai đoạn Hiểu dữ liệu (Data Understanding) bao gồm tất cả các hoạt động liên quan đến việc xây dựng và khám phá tập dữ liệu. Mục tiêu cốt lõi của giai đoạn này là trả lời câu hỏi: Dữ liệu đã thu thập có đại diện chính xác cho vấn đề cần giải quyết hay không?
Để đánh giá và khai thác tập dữ liệu ban đầu, các nhà khoa học dữ liệu áp dụng các phương pháp phân tích trọng tâm:
Thống kê đơn biến (Univariate statistics): Tính toán các đại lượng xu hướng trung tâm (trung bình, trung vị, yếu vị) và đại lượng đo độ phân tán (tối thiểu, tối đa, độ lệch chuẩn, phương sai, khoảng giá trị).
Tương quan theo cặp (Pairwise correlations): Xem xét mức độ liên hệ giữa các cặp biến để đưa ra quyết định loại bỏ biến dư thừa hoặc xử lý hiện tượng đa cộng tuyến.
Biểu đồ tần số (Histogram): Trực quan hóa phân phối giá trị của từng biến, giúp phát hiện sớm các giá trị bất thường (outliers) hoặc kỳ lạ trong dữ liệu.
Xử lý giá trị bất thường: Dựa trên phân tích thống kê, các giá trị dị biệt sẽ được phát hiện. Ví dụ: Trong biến phân phối tuổi thông thường từ 0 đến 115, nếu xuất hiện giá trị -1 hoặc 999, nhà khoa học dữ liệu cần tìm hiểu nguyên nhân gốc rễ để đưa ra phương án mã hóa lại hoặc loại bỏ thích hợp.
VideoIBM Data Science Methodology – Data Understanding (11:40), YouTube, tiếng Anh
2. Chuẩn bị dữ liệu (Data Preparation)
Giai đoạn Chuẩn bị dữ liệu (Data Preparation) tương tự như việc rửa sạch nguyên liệu tươi và cắt bỏ phần hư hỏng trước khi nấu ăn. Cùng với khâu thu thập và hiểu dữ liệu, chuẩn bị dữ liệu thường chiếm từ 70% đến 90% tổng thời gian của một dự án Khoa học dữ liệu.
Việc tự động hóa các quy trình thu thập và chuẩn bị dữ liệu trực tiếp trong cơ sở dữ liệu có thể giúp giảm bớt thời gian này xuống ít nhất 50%, cho phép các nhà khoa học dữ liệu tập trung nhiều nguồn lực hơn vào việc xây dựng mô hình.
Các hoạt động cốt lõi trong Chuẩn bị Dữ liệu:
Chuyển đổi dữ liệu (Data Transformation): Đưa dữ liệu về dạng dễ thao tác bằng cách xử lý giá trị bị thiếu (missing values), giá trị không hợp lệ, xóa dữ liệu trùng lặp và chuẩn hóa các định dạng dữ liệu.
Kỹ thuật tạo đặc trưng (Feature Engineering): Kết hợp tri thức chuyên môn ngành (domain knowledge) để tạo ra các thuộc tính hoặc đặc trưng mới, giúp các thuật toán học máy phát hiện ra các mẫu thông tin hiệu quả hơn.
Phân tích và mã hóa văn bản (Text Parsing): Trích xuất cấu trúc văn bản và mã hóa dữ liệu văn bản thành dạng số để thuật toán lập trình có thể xử lý mà không bỏ sót các thông tin ẩn.
Nghiên cứu tình huống (Case Study)
Trong nghiên cứu y tế thực tế về dự đoán nguy cơ tái nhập viện của bệnh nhân suy tim, thông qua giai đoạn hiểu dữ liệu, các nhà nghiên cứu phát hiện ra rằng định nghĩa ban đầu không bao quát hết tất cả các trường hợp nhập viện thực tế theo kinh nghiệm lâm sàng. Phát hiện này đòi hỏi toàn bộ đội ngũ phải điều chỉnh lại định nghĩa và quay lại giai đoạn trước để thu thập bổ sung dữ liệu.
VideoIBM Data Science Methodology – Data Preparation & Case Study (16:00), YouTube, tiếng Anh
Thực hành: Lab 4 – Từ Hiểu biết đến Chuẩn bị dữ liệu
Trong bài thực hành Lab 4, bạn sẽ tiếp tục bài toán xây dựng mô hình phân loại tự động nguồn gốc ẩm thực dựa trên tập dữ liệu các công thức nấu ăn.
Tải và khám phá dữ liệu: Sử dụng các thư viện Python như
pandas,numpy, vàređể đọc file dữ liệurecipes.csvtừ máy chủ IBM vào Dataframe.Chuẩn hóa dữ liệu: Kiểm tra các cột nguyên liệu, xử lý các thành phần dư thừa, cấu trúc lại bảng dữ liệu và mã hóa chuẩn bị cho bước mô hình hóa ở bài học tiếp theo.
Thời gian dự kiến thực hành: 120 phút.
Tổng kết bài học
Hoàn thành bài học này, bạn đã nắm được:
Giai đoạn Hiểu dữ liệu: Đảm bảo tập dữ liệu thu thập đại diện chính xác cho bài toán nghiệp vụ thông qua các công cụ thống kê đơn biến, đánh giá tương quan cặp và biểu đồ phân phối.
Giai đoạn Chuẩn bị dữ liệu: Thực hiện làm sạch dữ liệu, xử lý giá trị thiếu, loại bỏ trùng lặp, chuyển đổi định dạng và thực hiện Feature Engineering để tối ưu dữ liệu đầu vào cho mô hình.
Quiz 6
10 câu hỏi. Chọn đáp án rồi bấm “Nộp bài” để xem kết quả.