Bài 9: Công cụ Khoa học dữ liệu
Mục tiêu bài học
Trong bài học này, bạn sẽ được giới thiệu các công cụ, tiếp cận với các ngôn ngữ và hàng loạt thư viện được sử dụng trong Khoa học dữ liệu. Đồng thời, bạn cũng được cung cấp kiến thức về API, công cụ giúp kết nối các ứng dụng với nhau, và về tập dữ liệu, thứ cung cấp sức mạnh cho Khoa học dữ liệu.
Tổng quan về các ngôn ngữ cho Khoa học dữ liệu.
Nắm được ngôn ngữ Python và lý do vì sao Python được tin dùng trong khoa học dữ liệu.
Hiểu ngôn ngữ SQL và lý do vì sao SQL được tin dùng trong xử lý dữ liệu có cấu trúc.
Nắm được kiến thức và cách hoạt động của API, cung cấp phương thức kết nối giữa các phần mềm.
Hiểu được tầm quan trọng của tập dữ liệu trong khoa học dữ liệu.
1. Ngôn ngữ lập trình cho Khoa học dữ liệu
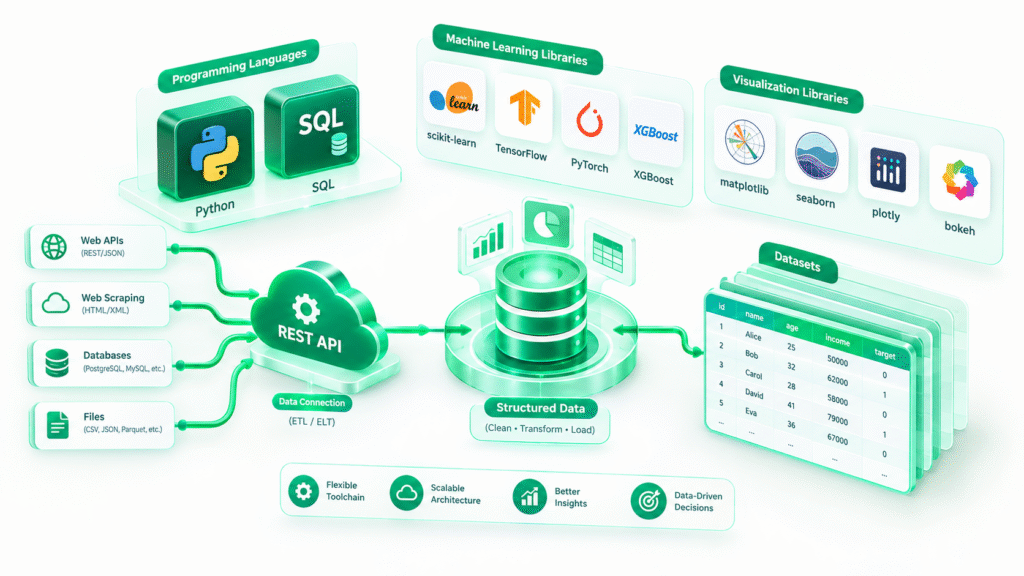
Có rất nhiều ngôn ngữ lập trình khác nhau. Mỗi ngôn ngữ lại có những thế mạnh và hạn chế riêng. Tuy nhiên trong khoa học dữ liệu, các chuyên gia khuyên dùng 3 ngôn ngữ chính là Python, R và SQL.
VideoNgôn ngữ lập trình cho Khoa học dữ liệu
Trong video tiếp theo, chúng ta sẽ tìm hiểu tổng quan về Python, ngôn ngữ chính được sử dụng trong khoa học dữ liệu. Lợi thế của Python trong khoa học dữ liệu là:
Lập trình ít cú pháp hơn so với ngôn ngữ khác.
Cung cấp thư viện mạnh mẽ cho tính toán khoa học như Pandas, NumPy, SciPy và Matplotlib.
Cung cấp thư viện mạnh mẽ cho Trí tuệ nhân tạo như TensorFlow, PyTorch, Keras và Scikit-learn.
Có thể sử dụng để Xử lý ngôn ngữ tự nhiên (NLP) bằng Natural Language Toolkit (NLTK).
VideoTổng quan về Python
Ở video tiếp theo, chúng ta sẽ tìm hiểu tổng quan về SQL. Mặc dù SQL không phải là ngôn ngữ dành riêng cho khoa học dữ liệu, nhưng các nhà khoa học dữ liệu thường xuyên sử dụng nó vì nó đơn giản và mạnh mẽ. Ngôn ngữ này hữu ích trong việc xử lý dữ liệu có cấu trúc, tức là dữ liệu kết hợp các mối quan hệ giữa các thực thể và biến. SQL được thiết kế để quản lý dữ liệu trong cơ sở dữ liệu quan hệ.
Biết SQL sẽ giúp bạn làm nhiều công việc khác nhau trong khoa học dữ liệu, bao gồm cả phân tích nghiệp vụ và phân tích dữ liệu; đó là điều bắt buộc trong kỹ thuật dữ liệu. Khi thực hiện các thao tác với SQL, bạn truy cập trực tiếp vào dữ liệu mà không cần phải sao chép nó trước. Điều này giúp tăng tốc độ thực thi quy trình công việc đáng kể. SQL là trình thông dịch giữa bạn và cơ sở dữ liệu.
Có nhiều cơ sở dữ liệu SQL khác nhau, bao gồm MySQL, IBM Db2, PostgreSQL, Apache OpenOffice Base, SQLite, Oracle, MariaDB, Microsoft SQL Server,… Cú pháp SQL bạn viết có thể thay đổi đôi chút tùy theo hệ quản trị cơ sở dữ liệu quan hệ bạn đang dùng.
VideoTổng quan về SQL
2. Thư viện cho Khoa học dữ liệu
Thư viện là một tập hợp các hàm và phương thức, cho phép bạn thực hiện nhiều hành động một cách hiệu quả mà không cần tự viết code chi tiết. Một số thư viện chính có thể kể đến như:
Thư viện tính toán khoa học bằng Python:
- Pandas: cung cấp các cấu trúc và công cụ để làm sạch, thao tác và phân tích dữ liệu hiệu quả.
- NumPy: được xây dựng theo cấu trúc mảng, cho phép bạn áp dụng các hàm toán học cho mảng.
Thư viện trực quan hóa bằng Python:
- Matplotlib: thư viện nổi tiếng nhất cho trực quan hóa dữ liệu, được dùng để tạo biểu đồ và đồ thị.
- Seaborn: giúp dễ dàng tạo các biểu đồ như bản đồ nhiệt, chuỗi thời gian và biểu đồ violin.
Thư viện học máy và học sâu bằng Python:
- Scikit-learn: chứa các công cụ để lập mô hình thống kê, bao gồm hồi quy, phân loại, phân cụm và những thứ khác; được xây dựng dựa trên NumPy, SciPy và Matplotlib nên dễ tương tác với các thư viện trong Khoa học dữ liệu.
- Keras: cho phép bạn xây dựng mô hình học sâu tiêu chuẩn; có thể chạy trên các đơn vị xử lý đồ họa (GPU) giúp tính toán nhanh hơn.
- TensorFlow: là một low-level framework được sử dụng trong môi trường production (sản xuất) cho mô hình học sâu.
- PyTorch: được sử dụng để thử nghiệm các mô hình học sâu, giúp các nhà nghiên cứu dễ dàng kiểm tra ý tưởng của họ.
Ngoài ra, cũng có một số công cụ và thư viện khác được sử dụng trong khoa học dữ liệu:
Apache Spark: là một framework tính toán cụm đa dụng, cho phép bạn xử lý dữ liệu bằng các cụm tính toán. Điều này có nghĩa là bạn có thể xử lý dữ liệu song song, dùng đồng thời nhiều máy tính để tăng hiệu quả tính toán. Spark có chức năng tương tự như Pandas, NumPy, Scikit-learn và có thể dùng với Python, R, Scala hoặc SQL. Có nhiều thư viện dành cho Scala, được dùng chủ yếu trong kỹ thuật dữ liệu nhưng đôi khi cũng được dùng trong khoa học dữ liệu.
Với Scala:
- Spark Vegas: thư viện trực quan hóa dữ liệu, có thể làm việc với các tệp dữ liệu cũng như Spark DataFrames.
- BigDL: thư viện cho học sâu.
Với R:
- Có chức năng tích hợp cho học máy và trực quan hóa dữ liệu.
- ggplot2: thư viện bổ sung phổ biến để trực quan hóa dữ liệu trong R.
VideoThư viện cho khoa học dữ liệu
3. API
Application Programming Interface (API) cho phép hai phần mềm tương tác với nhau. Ví dụ: bạn có phần mềm, dữ liệu và các thành phần phần mềm khác. Bạn có thể dùng API để giao tiếp với các phần mềm khác. Bạn không cần hiểu cách API hoạt động, chỉ cần biết đầu vào và đầu ra là gì.

Bản chất của thư viện Pandas là tập hợp các thành phần phần mềm được kết hợp lại với nhau, và Pandas không chỉ được viết bằng Python. Khi cần xử lý dữ liệu, bạn chỉ cần gọi API của Pandas để chúng tương tác với dữ liệu và thực thi những việc bạn yêu cầu.

Tiếp theo, bạn sẽ tìm hiểu về REST API. Đây là API cho phép giao tiếp giữa các ứng dụng thông qua Internet để tận dụng khả năng lưu trữ, truy cập dữ liệu lớn, các thuật toán trí tuệ nhân tạo và nhiều nguồn tài nguyên khác. REST hoạt động chủ yếu dựa trên giao thức HTTP: chương trình của bạn (Client) gửi request tới dịch vụ web bạn cần và dịch vụ trả về response cho bạn.

Watson Speech to Text API là một ví dụ về REST API, dùng để chuyển lời nói thành văn bản. Trong lệnh gọi API, bạn gửi một bản sao của tệp âm thanh muốn chuyển thành văn bản tới dịch vụ web của Watson qua Internet, quá trình này gọi là Request. Sau đó API trả về văn bản đã được chuyển từ âm thanh, quá trình này gọi là Response.
VideoApplication Programming Interfaces (API)
4. Tập dữ liệu Khoa học dữ liệu
Ở phần phương pháp luận, bạn đã dành phần lớn thời gian để làm việc với dữ liệu. Nếu không có dữ liệu thì rất khó để tìm ra giải pháp cho vấn đề của bạn. Vì vậy, trong phần này chúng ta sẽ tìm hiểu về tập dữ liệu, thứ cung cấp sức mạnh cho khoa học dữ liệu.
Tập dữ liệu là một tập hợp dữ liệu có cấu trúc. Dữ liệu bao gồm thông tin được biểu thị dưới dạng:
- Văn bản
- Số
- Hình ảnh
- Âm thanh
- Video
Tập dữ liệu có cấu trúc ở dạng bảng bao gồm một tập hợp các hàng và cột lưu trữ thông tin. Một định dạng dữ liệu bảng phổ biến là “các giá trị được phân tách bằng dấu phẩy” hay CSV.

Cấu trúc dữ liệu mạng hoặc cấu trúc dữ liệu phân cấp thường được dùng để biểu diễn các mối quan hệ giữa dữ liệu. Dữ liệu phân cấp được tổ chức theo cấu trúc cây, trong khi dữ liệu mạng có thể lưu trữ ở dạng đồ thị.

Tập dữ liệu cũng có thể bao gồm các file dữ liệu thô, chẳng hạn như hình ảnh hoặc âm thanh. Tập dữ liệu MNIST khá phổ biến trong khoa học dữ liệu. Nó chứa hình ảnh của các chữ số viết tay và thường được dùng để huấn luyện các hệ thống xử lý hình ảnh.

Theo truyền thống, hầu hết các tập dữ liệu được coi là riêng tư vì chứa thông tin độc quyền hoặc bí mật như dữ liệu khách hàng, dữ liệu giá cả hoặc các thông tin thương mại nhạy cảm khác. Theo thời gian, ngày càng có nhiều cơ quan công và tư như các tổ chức khoa học, chính phủ, tổ chức và thậm chí các công ty bắt đầu cung cấp tập dữ liệu cho công chúng dưới dạng “dữ liệu mở”, cung cấp nhiều thông tin miễn phí. Quyền truy cập vào dữ liệu mở cho phép các nhà khoa học dữ liệu, nhà nghiên cứu, nhà phân tích và những người khác khám phá thông tin hữu ích, tạo ra các ứng dụng mới vì mục đích thương mại và công ích, và thực hiện nghiên cứu mới.
Dữ liệu mở đóng vai trò quan trọng trong sự phát triển của khoa học dữ liệu, học máy và trí tuệ nhân tạo; đồng thời giúp người học trau dồi kỹ năng với nhiều tập dữ liệu.
VideoTập dữ liệu
Tổng kết bài học
Hoàn thành bài học này, bạn đã nắm được:
3 ngôn ngữ chính được sử dụng trong khoa học dữ liệu là Python, R và SQL.
Python là ngôn ngữ mạnh mẽ, được các chuyên gia khuyên dùng trong khoa học dữ liệu.
SQL dùng để xử lý dữ liệu có cấu trúc.
API cho phép kết nối các phần mềm với nhau.
REST API cho phép kết nối phần mềm thông qua giao thức HTTP.
Tập dữ liệu là sức mạnh của khoa học dữ liệu.
Quiz 9
10 câu hỏi. Chọn đáp án rồi bấm “Nộp bài” để xem kết quả.