Hướng dẫn Machine Learning, Pipeline, Triển khai và MLOps
Giới thiệu: Pipeline, Triển khai và MLOps là những khái niệm rất quan trọng đối với các nhà khoa học dữ liệu ngày nay. Xây dựng mô hình trong Notebook là chưa đủ. Triển khai pipeline và quản lý quy trình đầu-cuối theo các thực tiễn tốt của MLOps đang trở thành trọng tâm của nhiều công ty.
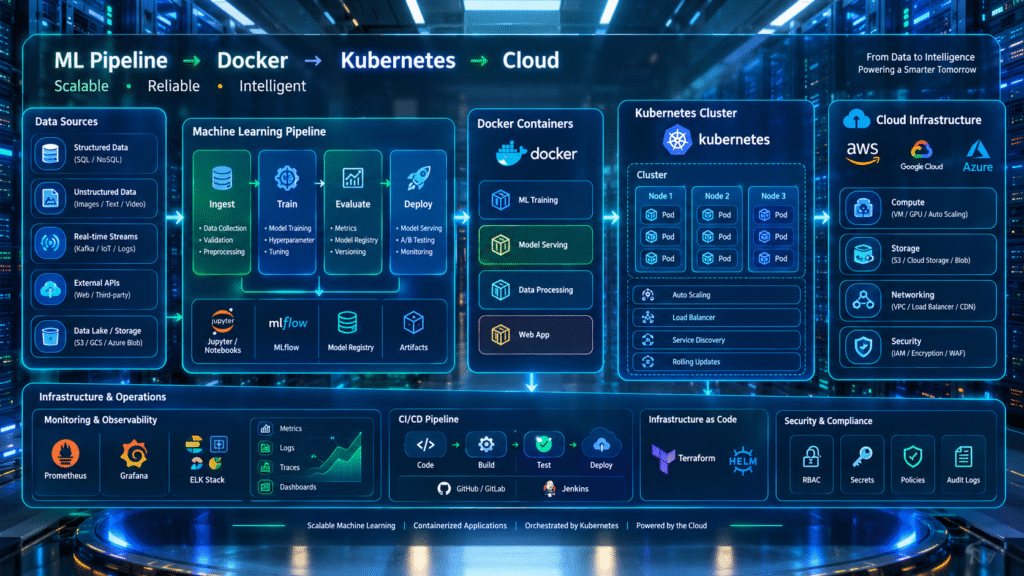
Hướng dẫn này thảo luận một số khái niệm quan trọng như Pipeline, CI/CD, API, Container, Docker, Kubernetes, các framework/thư viện MLOps trong Python và quy trình triển khai ứng dụng web ML dựa trên Flask lên đám mây Microsoft Azure.
Mục lục nội dung
1. Các khái niệm chính
MLOps
MLOps là viết tắt của Machine Learning Operations. MLOps tập trung vào việc tinh giản quy trình đưa các mô hình học máy vào môi trường sản xuất, sau đó duy trì và giám sát chúng. MLOps là một chức năng mang tính hợp tác, thường bao gồm nhà khoa học dữ liệu, kỹ sư ML và kỹ sư DevOps.
MLOps có thể bao trùm mọi thứ từ pipeline dữ liệu đến sản xuất mô hình học máy. Ở một số nơi, MLOps chỉ được triển khai cho phần đưa mô hình học máy vào sản xuất, nhưng cũng có những doanh nghiệp áp dụng MLOps trên nhiều khía cạnh của vòng đời phát triển ML, bao gồm Phân tích Dữ liệu Thăm dò (EDA), Tiền xử lý Dữ liệu, Huấn luyện Mô hình, v.v.

Vì sao cần MLOps? Các mục tiêu cốt lõi doanh nghiệp hướng tới khi áp dụng MLOps bao gồm:
- Tự động hóa: Giảm thiểu thao tác thủ công trong huấn luyện và cập nhật mô hình.
- Khả năng mở rộng: Dễ dàng đáp ứng lưu lượng truy cập và khối lượng dữ liệu lớn.
- Tái lập kết quả: Đảm bảo mô hình cho ra kết quả nhất quán trên nhiều môi trường khác nhau.
- Giám sát & Quản trị: Theo dõi hiệu suất, độ trôi của mô hình (Model Drift) và quản lý rủi ro.
MLOps so với DevOps & CI/CD
DevOps là cách tiếp cận lặp để đưa ứng dụng phần mềm vào sản xuất. MLOps vay mượn các nguyên tắc tương tự để đưa mô hình học máy vào sản xuất nhằm nâng cao chất lượng và khả năng kiểm soát ứng dụng.
CI/CD (Continuous Integration / Continuous Delivery / Continuous Deployment): Là thực hành tự động hóa quy trình liên tục phát hiện vấn đề, đánh giá lại và tự động cập nhật các mô hình học máy. Nó giảm đáng kể nhu cầu nhà khoa học dữ liệu can thiệp thủ công, giúp quy trình hiệu quả, nhanh chóng và ít sai sót do con người.

Pipeline
Pipeline học máy là cách kiểm soát và tự động hóa quy trình làm việc để tạo ra một mô hình học máy. Pipeline học máy gồm nhiều bước tuần tự, từ trích xuất và tiền xử lý dữ liệu đến huấn luyện và triển khai mô hình.
# Ví dụ về pipeline học máy đơn giản trong Python với scikit-learn
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.linear_model import LogisticRegression

# Định nghĩa pipeline xử lý và huấn luyện
ml_pipeline = Pipeline([
    ('imputer', SimpleImputer(strategy='median')),
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])
Triển khai (Deployment) & API
Triển khai (Deployment): Là quá trình đưa mô hình vào môi trường sản xuất, nơi các ứng dụng web, phần mềm doanh nghiệp (ERP) và API có thể sử dụng mô hình đã huấn luyện bằng cách cung cấp dữ liệu mới và nhận về dự đoán.
API (Application Programming Interface): Là điểm cuối (endpoint) cho phép các ứng dụng giao tiếp với nhau. Trong MLOps, API đóng vai trò làm cầu nối nhận đầu vào từ người dùng và trả về kết quả dự đoán từ mô hình học máy.
Container, Docker và Kubernetes
| Khái niệm | Định nghĩa | Vai trò trong MLOps |
|---|---|---|
| Container | Loại phần mềm đóng gói ứng dụng và toàn bộ phụ thuộc (libraries, dependencies). | Đảm bảo ứng dụng chạy ổn định và đồng nhất giữa các môi trường tính toán khác nhau. |
| Docker | Công cụ cho phép người dùng xây dựng, chạy và quản lý container thông qua Dockerfile. |
Đóng gói mô hình ML, ứng dụng web và môi trường Python thành một gói duy nhất. |
| Kubernetes | Hệ thống mã nguồn mở điều phối và quản lý các cụm (clusters) ứng dụng dạng container. | Tự động cân bằng tải, mở rộng quy mô (scaling) và quản lý vận hành container ở cấp độ doanh nghiệp. |

2. Framework và Thư viện MLOps trong Python
- MLflow: Nền tảng mã nguồn mở quản lý toàn bộ vòng đời ML (Tracking, Projects, Models, Model Registry).
- Metaflow: Thư viện do Netflix phát triển giúp quản lý các dự án khoa học dữ liệu từ thử nghiệm đến sản xuất.
- Kubeflow: Nền tảng điều phối các quy trình ML phức tạp chạy trực tiếp trên hạ tầng Kubernetes.
- Kedro: Framework Python tạo mã nguồn khoa học dữ liệu có tính mô-đun, dễ bảo trì và tái lập.
- FastAPI: Framework Web hiệu năng cao dành cho việc phát triển RESTful API trong Python.
- ZenML: Framework MLOps mã nguồn mở giúp tạo pipeline ML sẵn sàng cho sản xuất trên nhiều hạ tầng đám mây.
3. Ví dụ thực hành: Phát triển, Triển khai Pipeline Đầu-cuối
Bước 1: Huấn luyện và Lưu trữ Pipeline Học máy (PyCaret)
Chúng ta xây dựng mô hình dự đoán chi phí bảo hiểm dựa trên thông tin nhân khẩu và rủi ro sức khỏe của bệnh nhân:
# Import thư viện PyCaret
from pycaret.datasets import get_data
from pycaret.regression import *

# 1. Tải dữ liệu
insurance = get_data('insurance')

# 2. Khởi tạo môi trường tiền xử lý dữ liệu
r1 = setup(insurance, target = 'charges', session_id = 123,
           normalize = True,
           polynomial_features = True,
           trigonometry_features = True,
           feature_interaction = True,
           bin_numeric_features = ['age', 'bmi'])

# 3. Huấn luyện mô hình Linear Regression
lr = create_model('lr')

# 4. Lưu lại toàn bộ Pipeline tiền xử lý và Mô hình
save_model(lr, model_name = 'deployment_28042020')
Bước 2: Xây dựng Back-end Flask (app.py)
Mã nguồn dưới đây nhận yêu cầu dự đoán từ giao diện Web HTML hoặc gọi trực tiếp qua REST API:
from flask import Flask, request, url_for, redirect, render_template, jsonify
from pycaret.regression import load_model, predict_model
import pandas as pd
import numpy as np

app = Flask(__name__)

# Tải mô hình đã lưu
model = load_model('deployment_28042020')
cols = ['age', 'sex', 'bmi', 'children', 'smoker', 'region']

@app.route('/')
def home():
    return render_template("home.html")

@app.route('/predict', methods=['POST'])
def predict():
    int_features = [x for x in request.form.values()]
    final = np.array(int_features)
    data_unseen = pd.DataFrame([final], columns=cols)
    prediction = predict_model(model, data=data_unseen, round=0)
    prediction = int(prediction.Label[0])
    return render_template('home.html', pred='Expected Bill will be ${}'.format(prediction))

@app.route('/predict_api', methods=['POST'])
def predict_api():
    data = request.get_json(force=True)
    data_unseen = pd.DataFrame([data])
    prediction = predict_model(model, data=data_unseen)
    output = prediction.Label[0]
    return jsonify(output)

if __name__ == '__main__':
    app.run(debug=True)
Bước 3: Đóng gói Container bằng Docker
Tạo một tệp tên Dockerfile trong thư mục dự án:
FROM python:3.7

RUN pip install virtualenv
ENV VIRTUAL_ENV=/venv
RUN virtualenv venv -p python3
ENV PATH="$VIRTUAL_ENV/bin:$PATH"

WORKDIR /app
ADD . /app

# Cài đặt các thư viện phụ thuộc
RUN pip install -r requirements.txt

# Mở cổng 5000 cho ứng dụng Flask
EXPOSE 5000

# Chạy ứng dụng
CMD ["python", "app.py"]
Bước 4: Dựng Image, Đẩy lên Azure Container Registry (ACR) & Triển khai
Thực hiện các dòng lệnh sau trên Terminal / Command Prompt:
# 1. Dựng Docker Image cục bộ
docker build -t pycaret.azurecr.io/pycaret-insurance:latest .

# 2. Kiểm thử Container trên máy cục bộ (truy cập localhost:5000)
docker run -d -p 5000:5000 pycaret.azurecr.io/pycaret-insurance

# 3. Đăng nhập vào Azure Container Registry
docker login pycaret.azurecr.io

# 4. Đẩy Image lên Azure Cloud
docker push pycaret.azurecr.io/pycaret-insurance:latest
4. Kết luận
MLOps đóng vai trò then chốt trong việc đảm bảo các mô hình Machine Learning sau khi triển khai được bảo trì tốt, hoạt động đúng kỳ vọng và không gây rủi ro vận hành do hiện tượng trôi dạt dữ liệu (Data Drift). Áp dụng quy trình MLOps bài bản sẽ giúp doanh nghiệp chuyển đổi từ việc thử nghiệm mô hình trong Notebook sang một hệ thống trí tuệ nhân tạo có khả năng mở rộng và hoạt động bền vững trong thực tế.